
我要打十个:深入理解 MMoE 多任务学习
从 Shared-Bottom 的负迁移问题出发,拆解 MMoE 的共享专家、任务门控与任务塔,说明它为何有效、没有解决什么,以及推荐系统落地时真正需要关注的工程问题。
视频推荐通常不只优化一个目标。点击率高,不代表用户愿意看完;播放时长高,也不一定产生点赞、收藏或转发。如果为每个目标各训一套模型,共享信号会被浪费,训练和部署成本也会增加;如果把所有任务硬塞进同一个共享网络,又可能出现一个任务变好、另一个任务变差的“跷跷板”。
MMoE(Multi-gate Mixture-of-Experts)要解决的核心问题是:既共享参数,又允许不同任务以不同方式使用共享参数。
从 Shared-Bottom 说起
最常见的多任务结构是 Shared-Bottom:底层网络抽取公共表示,上层为每个任务建立独立的 Tower。
设输入为 ,共享网络为 ,任务 的 Tower 为 ,则预测为:
它的优点很明确:参数经济、训练简单,相关任务还能互相提供额外监督。但它也施加了一个很强的假设——所有任务都必须从同一个底层表示出发。
当任务关系较弱、标签噪声不同、样本量不均衡,或者各任务的损失梯度长期争夺同一组参数时,硬共享可能造成负迁移。注意,这并不意味着 Shared-Bottom 是错误模型;在任务高度相关时,它仍然可能是最简单而强大的基线。
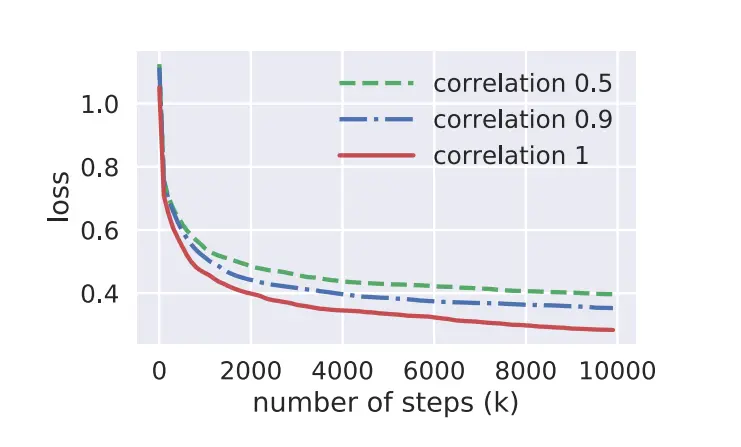
原论文用合成数据控制任务相关性。相关性降低时,Shared-Bottom 的训练损失明显变差,说明共享表示越来越难同时服务多个目标。
从一个共享网络到多个 Expert
Mixture-of-Experts(MoE)的第一步,是把单一共享网络换成 个 Expert:
是第 个 Expert 的输出,Gate 为它们分配权重。若使用 softmax,权重满足:
这让模型不再依赖唯一的共享表示,而能随输入改变 Expert 的组合。但如果所有任务仍共用同一个 Gate,那么同一条样本送给每个任务的混合表示仍完全相同。这种结构通常称为 One-gate MoE(OMoE)。
MMoE 的关键:每个任务一个 Gate
MMoE 共享一组 Expert,却为每个任务建立独立 Gate。设共有 个任务,第 个任务的计算过程是:
这里有三个容易混淆的角色:
- Expert 是跨任务共享的,负责学习可复用的表示;
- Gate 是任务专属的,而且依赖当前样本,为该任务计算 Expert 权重;
- Tower 也是任务专属的,把混合表示映射为最终预测。
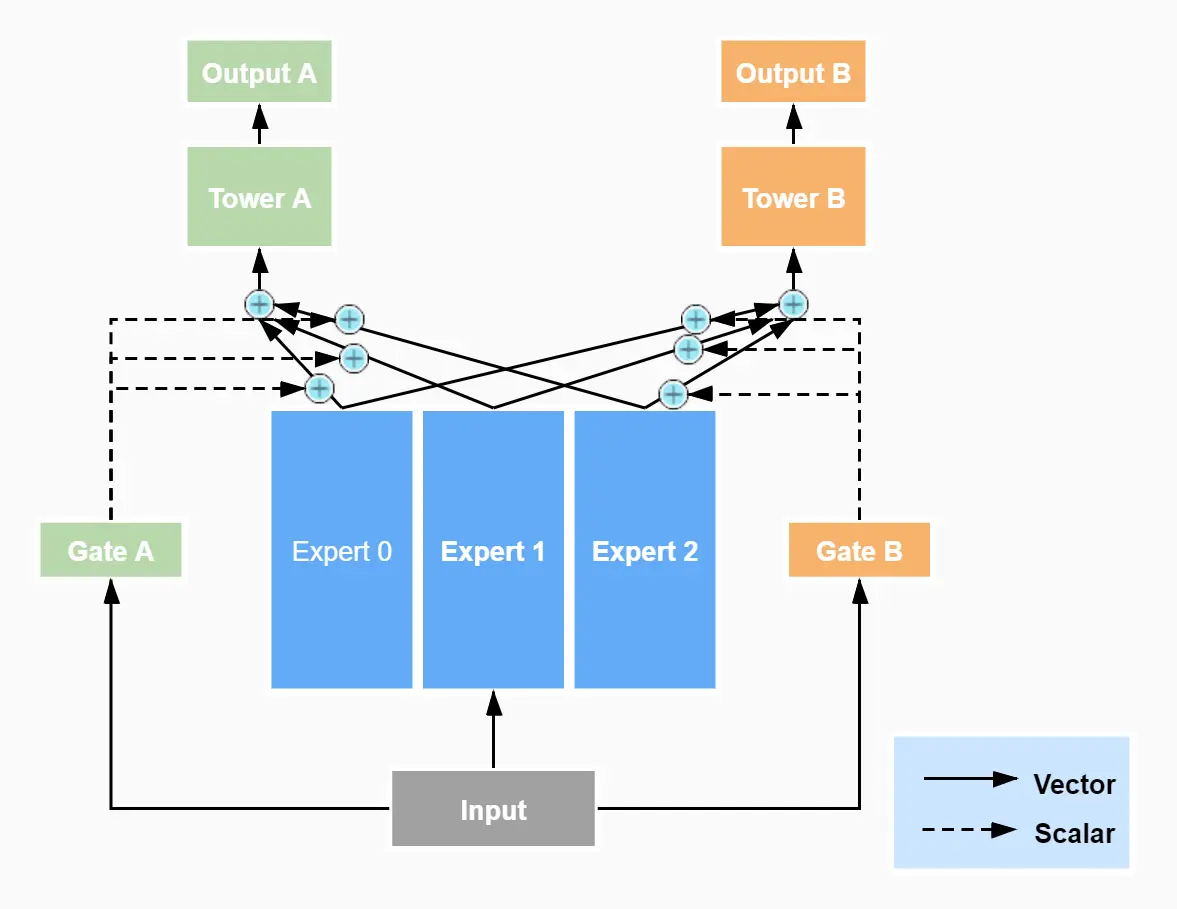
因此,同一条视频可以在“是否点击”任务中偏重一组 Expert,在“观看时长”任务中偏重另一组;同一任务面对不同视频和用户时,也可以改变混合比例。它学习的是样本相关、任务相关的软共享方式。
Expert 并不是预先规定好的“体育专家”“美食专家”,也不要求一个 Expert 对应一个任务。它们是端到端学习出的子网络,是否形成可解释分工,要看数据和优化结果,不能只凭 Gate 权重给它们贴语义标签。
MMoE 为什么可能更稳健
Shared-Bottom 要求所有任务接受同一个共享表示;OMoE 虽然增加了 Expert,但所有任务仍使用同一种混合;MMoE 则让各任务拥有不同组合,给模型增加了缓解冲突的结构自由度。
原论文在不同任务相关性的合成数据上比较了三种结构。任务相关性较低时,MMoE 的优势更明显;两个任务完全相同时,三者差距缩小。这支持的结论是“多 Gate 在这些设置下更稳健”,而不是“任务越冲突,MMoE 必然越好”。
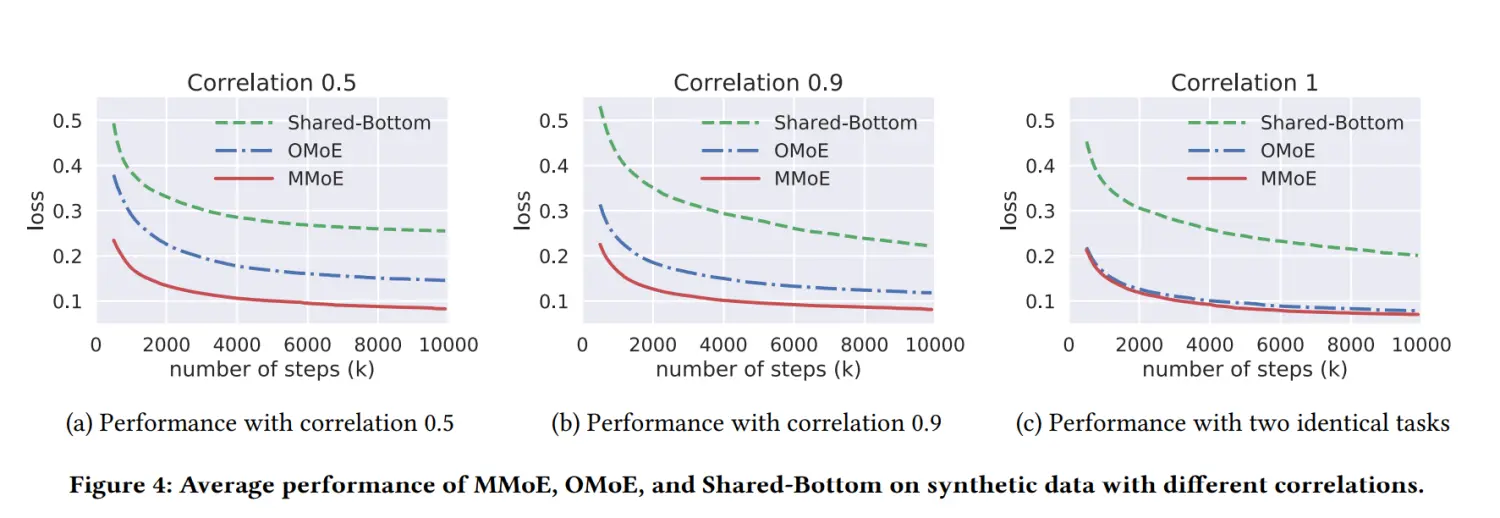
从优化角度看,MMoE 仍然共享 Expert 参数,多个任务的梯度仍会在 Expert 内相遇。独立 Gate 可以改变每个任务使用 Expert 的比例,却不会自动消除梯度冲突、损失尺度差异或任务优先级问题。
训练目标与实现骨架
多任务总损失通常写成:
由任务类型决定,例如点击可用二分类交叉熵,观看时长可用回归、分桶分类或生存分析目标。 控制业务和优化权重,但它不是 MMoE 自动学习出来的答案。
一次前向传播可以概括为:
experts = stack([expert(x) for expert in expert_layers])

outputs = []
for gate, tower in zip(task_gates, task_towers):
    weights = softmax(gate(x), dim=-1)
    mixture = sum(weights[i] * experts[i] for i in range(num_experts))
    outputs.append(tower(mixture))
原始 MMoE 使用的是 dense softmax routing:通常每个 Expert 都要计算,再做加权求和。它不同于大语言模型中常见的 sparse/top-k MoE,不能据此宣称只激活少数 Expert 或自动降低推理 FLOPs。
推荐系统落地时更难的部分
结构写对只是第一步。真正影响效果的,往往是下面这些问题。
1. 损失和样本不在同一量级
点击样本多而稠密,点赞和转发可能非常稀疏;观看时长的数值范围又与分类损失不同。直接把损失相加,某个任务可能仅凭样本量或梯度尺度主导共享 Expert。需要联合检查损失权重、任务采样、梯度范数和各任务的独立指标。
2. Gate 不保证 Expert 自动分工
不同 Expert 可能学到近似功能,也可能有少数 Expert 长期获得很低权重。可以观察每个任务的 Gate 均值、熵、Expert 利用率和多随机种子方差,但不要把“权重看起来不同”直接等同于学到了稳定语义。
3. Expert 越多不一定越好
Expert 数是容量超参数,不等于任务数。增加 Expert 会增加参数和计算,也可能带来冗余、过拟合或训练不稳定。论文实验中常见的 8 个 Expert 只是配置,不是默认最优值。
4. 任务依赖关系仍需显式建模
点击到转化往往存在漏斗关系。MMoE 只学习共享表示,不会自动表达“先点击才可能转化”的条件依赖。若业务依赖标签空间或因果顺序,还需要相应的多任务结构和数据定义。
5. 离线增益不等于线上收益
多目标推荐最终仍要面对校准、目标融合、延迟、流量分布变化和策略反馈。不能只汇报一个任务的 AUC;至少应同时观察所有任务的离线指标、任务间折中、推理成本和线上业务指标。
什么时候值得尝试 MMoE
MMoE 比较适合这些场景:同一输入需要预测多个目标,任务之间既有共享信号又存在差异;Shared-Bottom 已经出现明显折中;完全独立模型又浪费共同数据或增加部署成本。
如果任务的输入模态、样本集合和时间粒度完全不同,或者任务几乎没有共享信息,强行共用 Expert 池未必优于独立模型。若主要问题是标签偏差、极端稀疏或业务目标定义错误,换成 MMoE 也不会从结构上解决它们。
总结
MMoE 的精髓不是“很多专家”,而是共享 Expert、任务独立 Gate、任务独立 Tower。它把 Shared-Bottom 的硬共享改成输入相关的软共享,让模型能够从数据中学习不同任务应该如何组合公共能力。
这种自由度可以缓解所有任务被迫使用同一表示的问题,但不等于自动解决负迁移。真正可靠的实践仍要处理损失平衡、样本偏差、Expert 利用率、任务依赖和线上目标。